归档说明:本文于 2026 年 11 月 12 日上线,页面日期用于系列归档;案例发生时间以正文为准。
基于 2026 年 11 月一次真实的 Dify 1.9.1 工作流排障整理,文中的接口域名已脱敏为
example.com。
很多人搭建好一条 AI 工作流后,一旦发现最后大模型给出的结论不对,第一反应往往是去改提示词(Prompt),或者怀疑模型温度(temperature)设高了。
但今年 11 月我在排查一条接口安全检查工作流时,追到最后发现:大模型其实完全是按它看到的证据在说话,真正把整条链路带沟里去的,是用户在多行文本框里顺手多敲的那个回车。
一、故障现象:正常接口怎么突然变成 404 了?
当时我在本地跑一套基于 Dify 1.9.1 的接口安全检查工作流。它的任务很简单:接收用户填入的接口地址,依次发起正常请求和探测请求,最后把两边的 HTTP 状态码、响应头和响应正文交给大模型,判断目标接口是否存在未授权访问风险。
测试时,我填入了本地靶场的一个已知接口 http://example.com:8980/v2。按理说,这个接口在当前测试环境下是正常开放的,直接访问应该返回 HTTP 200 和一段 JSON 数据。
然而工作流跑完后,HTTP 请求节点返回的却是 404 Not Found,下游的大模型节点也老老实实地根据这份 404 响应,给出了“未发现未授权访问风险”的结论。
这就很蹊跷了:明明在终端里用 curl 直接请求是 200,为什么一进工作流就成了 404?
二、顺着节点往下追:一个 \n 的漂流记
我把工作流里每个节点的输入和输出逐个展开核对,很快就抓到了罪魁祸首。整条数据流是这样一步步跑偏的:
1. 入口表单用的是多行文本框(paragraph)
工作流的起始节点定义了一个名为 in_url 的输入变量,控件类型选了多行文本(paragraph),用来支持一次填入多个接口。我在粘贴完 http://example.com:8980/v2 之后,顺手按了一下回车,结果传进工作流的原始字符串变成了:
"http://example.com:8980/v2\n"2. Python 代码节点原样透传了空白字符
紧接着的 Python 代码节点原本负责对输入做预处理,但当时的代码只做了最简单的非空判断,既没有调用 .strip(),也没有按行切分后过滤空行:
# 当时未做清洗的写法(反例)
def main(in_url: str) -> dict:
    return {"target_url": in_url}
于是那个末尾的 \n 毫发无损地混过了代码节点。
3. 模板转换节点把换行符拼进了最终 URL
随后的模板节点用 Jinja2 语法 {{ target_url }} 直接生成待请求的 URL,末尾依然挂着那个看不见的换行符。
4. HTTP 节点将其编码为 %0A 发往服务端
当这个带有尾随换行符的字符串进入 Dify 的 HTTP 请求节点时,底层客户端对 URL 路径进行了百分号编码,把 \n(ASCII 0x0A)转成了 %0A。最终真正发到服务端上的请求变成了:
GET /v2%0A HTTP/1.1
Host: example.com:8980在服务端路由看来,/v2%0A 和 /v2 完全是两个不同的路径,自然干脆利落地返回了 404 Not Found。
5. 大模型基于“假证据”得出了反结论
到了最后一步,大模型节点收到的上下文是:“请求目标接口返回 404”。模型本身并不知道前面的 URL 被污染了,只能据此推断该接口不可访问或不存在泄露。一个小小的输入清洗疏漏,就这样演变成了安全审计上的漏报。
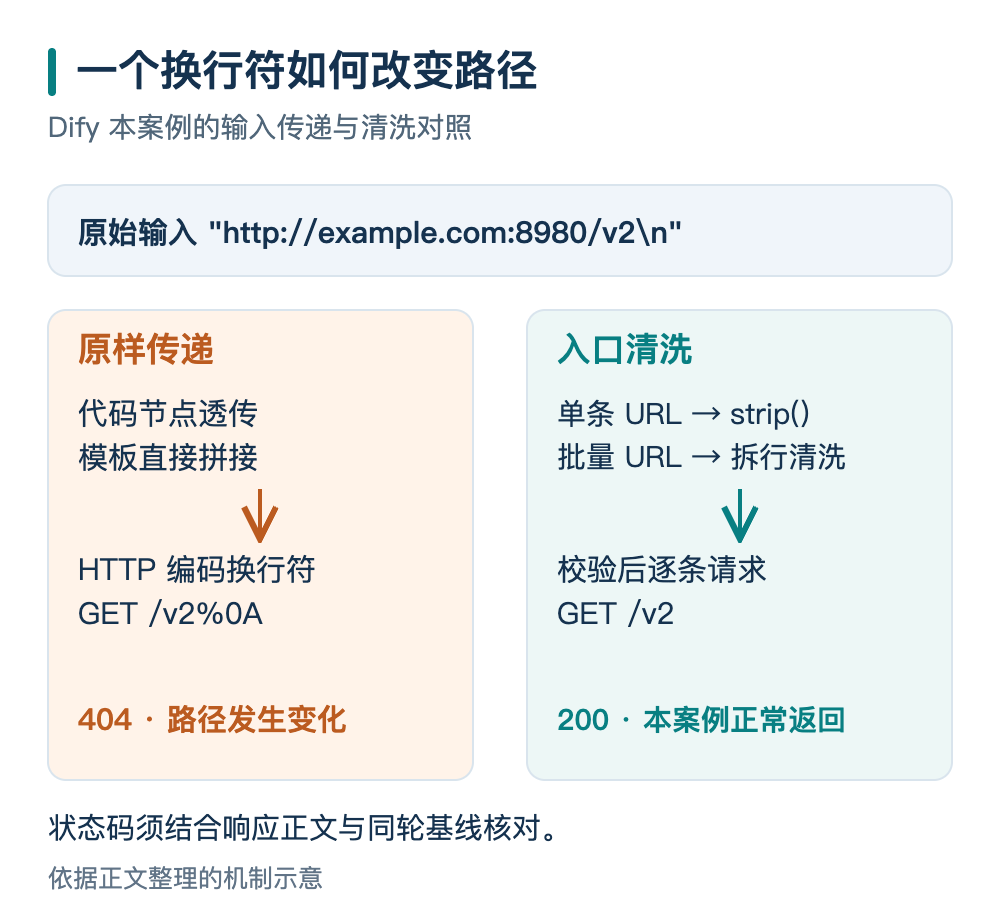
图 1:尾随换行经节点透传和编码成为 %0A,改变实际请求路径。入口清洗后,本案例恢复正常返回。(机制示意,点击图片可放大。)
三、修复方案:在入口处把脏数据拦干净
找到根因之后,修起来其实非常快。但为了防止以后换个人填表单又踩进同一个坑,不能只靠提醒使用者“粘贴时别按回车”,而要在工作流的前置节点里把清洗规则写死。
1. 如果本来只处理单个 URL,改用单行文本并强制 .strip()
如果一条工作流每次只检查一个接口,入口控件直接改成单行文本(text-input)最省心。同时在紧跟着的 Python 节点里统一做清洗和格式校验:
from urllib.parse import urlsplit

def main(in_url: str) -> dict:
    cleaned = (in_url or "").strip()
    if not cleaned:
        raise ValueError("输入 URL 不能为空")
    parsed = urlsplit(cleaned)
    if parsed.scheme not in {"http", "https"} or not parsed.netloc:
        raise ValueError(f"非法的 URL 格式: {cleaned!r}")
    if any(ch in cleaned for ch in ("\r", "\n", "\t", " ")):
        raise ValueError(f"URL 中包含非法空白字符: {cleaned!r}")
    return {"target_url": cleaned}
2. 如果确实需要批量输入多行 URL,先按行切分、去重、过滤空行
如果业务上确实需要用 paragraph 一次贴入十几个接口,那 Python 节点就必须承担起“拆行 + 去空白 + 过滤注释/空行”的职责,输出一个干净的字符串列表交给下游的迭代(Iteration)节点逐个请求:
from urllib.parse import urlsplit

def main(in_url: str) -> dict:
    urls = []
    seen = set()
    for raw_line in (in_url or "").splitlines():
        line = raw_line.strip()
        if not line or line.startswith("#"):
            continue
        parsed = urlsplit(line)
        if parsed.scheme not in {"http", "https"} or not parsed.netloc:
            raise ValueError(f"发现格式错误的 URL 行: {raw_line!r}")
        if line not in seen:
            seen.add(line)
            urls.append(line)
    if not urls:
        raise ValueError("未解析出任何有效的 URL")
    return {"target_urls": urls}
3. 在下游日志里打印“实际发出的 URL”
除了在入口处做清洗,我还养成了另一个习惯:在 HTTP 节点的下游(或调试输出里)把最终构造出来的完整请求路径原样打出来。一旦看到路径末尾带着 %0A、%0D 或者 %20,一眼就能反应过来是字符串拼接出了毛病,不用再去翻半天服务端日志。
四、给工作流排障留一份自查清单
这次排障花的时间不算长,但它提醒了我一件很重要的事:在 Dify、n8n 或自研 Agent 框架里,模板节点、代码节点和 HTTP 节点之间传递的只是普通字符串。当你看到工作流最终输出的结果不对劲时,先别急着跟大模型的 Prompt 较劲,不妨按下面这四步先查一轮底层的输入输出:
- 看原始输入的
repr():多行文本框、从 Excel/飞书表格复制过来的单元格、文件末尾的一行,极容易夹带\r、\n、不间断空格(\u00a0)或零宽字符; - 看中间模板有没有多出换行:Jinja2 模板如果为了排版好看在变量前后加了换行,有时也会一并拼进输出字符串里;
- 看 HTTP 节点的实际请求路径:核对状态码之前,先确认请求发往的到底是
/v2还是/v2%0A; - 看基线请求通不通:如果连正常的带认证基线请求都返回了 404,那首先应该怀疑输入格式或环境连通性,而不是直接下“接口安全”的结论。
把这些不起眼的字符串边界收拾干净,后面的大模型才能真正发挥它的分析作用。