归档说明:本文于 2026 年 11 月 12 日上线,页面日期用于系列归档;案例发生时间以正文为准。
文中时间取自可核实的对话与任务记录,示例路径、域名和参数均已脱敏。
回头看这两年用大模型的记录,变化其实挺明显的。2025 年年中,我主要把它当成一个随时在线的技术搭档:发截图、贴报错、问概念、要一段脚本。到了 2025 年底至 2026 年,问题慢慢变成了另一类:工具怎么发现、工作流怎么拆、证据怎么留、Agent 为什么说自己完成了却其实没做完。
这篇文章不想讲宏大的 AI 趋势,只想按时间线梳理一下,我是怎么从“把模型当问答框”走到“把模型放进工程与安全流程里”的。
一、先把它当成高频排障和出题助手
目前能查到的最早一条记录是 2025 年 6 月底到 7 月初,当时在折腾一个 Unity Demo。那时候的用法非常直接:把界面截图和已有代码片段丢给模型,问怎么在游戏界面顶部加血条、怎么调字体大小、为什么碰撞检测没反应,顺手让它给出一份带操作步骤的说明。那会儿最看重的是反应快,能帮我把散乱的改动迅速理顺。
到了 2025 年 7 月 14 日,使用方式往前迈了一小步,开始用它辅助安全题目的设计与验证。当时我想做一道加密 VoIP 流量的 CTF 题目,核心思路是让选手设法拿到泄露的会话密钥,再去解密抓包里的通话音频。如果靠手工一点点拼测试数据会非常慢,于是我先让模型帮我生成了一套最小可运行的实验脚本:一边发加密音频流,一边接收还原。
但没过多久我就意识到一个问题:如果只是把现成工具粘在一起,题目本身的考察点反而太浅了。我接着追问了几个更细的设计问题,比如能不能在 Python 里自己定义一套音频传输封装?怎么把题目难度放进协议解析和密钥定位里,而不是单纯考选手会不会调现成命令?从那次开始,我不再满足于“让模型给一段能跑的代码”,而是习惯跟它来回推敲背后的协议结构和题目边界。
没过几天(7 月 22 日),我又开始梳理 AI 大模型安全方向的入门路径,专门找像 Gandalf 这类偏实战闯关的训练环境。现在回头看,那段时间虽然还处在单轮或多轮问答阶段,但关注点已经慢慢聚拢到了“代码、流量、攻防场景和大模型本身的安全问题”上。
二、问题开始变成“能力怎么接进系统”
当模型回答单个问题越来越顺手之后,新的瓶颈很快就冒出来了:如果每次都要靠人把背景材料、工具说明、接口地址和输出格式手动粘进对话框,这套流程根本没法复用。
2025 年 12 月 22 日,我在尝试用 Dify 搭建一套类似 Claude Skills 的工具调用链。当时的设想是:把每个工具的功能描述、调用方式和 API 路由存进知识库;第一个节点负责理解用户意图并从知识库里检索匹配的工具,第二个 Agent 节点再根据检索出来的说明去发起 OpenAPI 调用。
这套方案听起来很顺,但真正往深处想就会撞上几个工程问题:
- 知识库召回的只是“一段关于工具的文字描述”,不是一个自带类型约束的函数签名;
- 负责检索的节点和负责执行的节点之间,需要有一份格式稳定的中间契约,不能靠自由发挥的自然语言传话;
- 如果接口路由和参数拼装完全交给模型临场发挥,一旦检索结果跑偏,后面就会直接发起错误的外部调用。
紧接着在 2025 年 12 月底到 2026 年 1 月初,我又连续推进了两份更贴近业务落地的方案:一份是 AISOC 安全运营智能体的记忆模块设计,重点考虑怎么把安全运营里的历史处置经验沉淀下来,变成后续告警研判能直接调用的上下文;另一份是 API 安全智能体的需求与评测方案,要求模型不仅能发现风险,还得交代清楚风险触发的前提条件,不能看到一个可疑响应就直接报高危漏洞。
也是从这个阶段开始,我向模型提的问题变了:不再是“帮我写段脚本”,而是“工具描述放哪一层”“状态怎么跨节点传递”“产出物拿什么标准验收”。
三、在工作流和长任务里踩到的真坑
到了 2026 年 3 月至 4 月,我开始把定时巡检、资产收集、记忆机制、沙箱隔离和多 Agent 协作真正串进日常工作流里。跑得越多,踩到的坑也越具体。
最典型的一个坑发生在 2026 年 3 月 10 日:某条 Agent 流程明明已经在前面的步骤里拿到了所需的查询结果,却还是没完没了地重复发起同样的查询。
这种毛病单靠在 Prompt 里加一句“请不要重复调用工具”往往很难根治。因为对模型来说,只要当前上下文里没有一个明确的“任务已完成/结果已满足”状态标记,或者工具返回的结果没有被整理成清晰的终止信号,它就很容易顺着惯性再调一轮。
到了 2026 年 10 月,在参与腾讯 TSecBench 平台的智能体实测以及本地 Dify 工作流排障时,这类问题集中爆发了:
- 有的运行实例里,HTTP 请求返回了高达 86% 的重复响应,或者在 66 次调用里花了 43 次去手工解码同一份 PNG,把调用预算白白耗光;
- 有的多 Agent 任务里,子 Agent 在汇报里写得头头是道,说自己已经改完并验证通过了,但去查底层产物时却发现关键验证步骤压根没跑;
- 在 Dify 1.9.1 的一条工作流里,仅仅因为多行输入末尾多带了一个换行符,经过脚本节点原样透传、模板节点直接拼接后,拼进 HTTP 节点的请求路径就从
/v2变成了/v2%0A,导致原本应该返回 200 的正常请求变成了 404,进而把后面的安全审计结论彻底带偏。
这些实打实的翻车现场让我彻底认清了一件事:把大模型放进工程和网安流程里,真正难的从来不是“让它生成一段像模像样的文字”,而是保证整条链路在面对脏输入、重复响应和异常分支时依然算得准、停得下。
四、我现在设计 Agent 时坚持的五条原则
踩过上面这些坑之后,我现在无论是写安全审计工具、搭 Dify 工作流,还是设计多 Agent 协作任务,都会先拿下面五条标准过一遍:
1. 先清洗输入,再谈提示词
凡是来自外部表单、资产列表、文件读取或上游节点的字符串,进核心逻辑前先做 trim、去空行、校验格式和长度。不要指望大模型在拼 URL 或写参数时会自动帮你过滤掉一个隐藏的 \n。
2. 工具调用必须有宿主侧的硬边界
知识库和 Skill 文档只能用来帮模型“挑选工具”和“理解步骤”,真正的请求路由、允许调用的动作集合以及目标 IP/域名范围,必须由宿主代码独立校验。即使模型被外部响应里的提示词注入带偏了,越界的调用提案也应该在执行门前被确定性代码直接拦下。
3. 用“有效观察”而不是“调用次数”来衡量进度
在长周期的安全测试或排障任务里,不能因为工具还在不断生成新文件、返回 HTTP 200,就认为任务在往前推进。必须给工具返回的一手观察建立去重指纹(剥掉请求 ID、时间戳等易变字段):如果连续多轮没有拿到新的实质信息,运行时就应该主动触发停滞收尾,而不是任由模型把预算烧光。
4. 审计结论必须绑定同轮对照证据
做 API 未授权或越权验证时,不能光看单个匿名请求返回了 200 还是 404。必须把同一轮里的“带凭证基线响应”和“去凭证探测响应”摆在一起比对:基线本身不通(比如凭证过期或路由已下线),或者去凭证时忘了把 Cookie 一块清掉,都应该归入“待核实”,绝不能草率标成“防护有效”或“发现漏洞”。
5. “任务完成”不能只听模型自述
无论是让 Agent 审计接口还是维护线上服务,都不能因为它最后输出了一句“已全部处理完毕”就信以为真。必须由独立的验证步骤去检查实际产物:文件到底落盘没有、断言测试过没过、备份存不存在、线上状态码和证书有效期对不对得上。
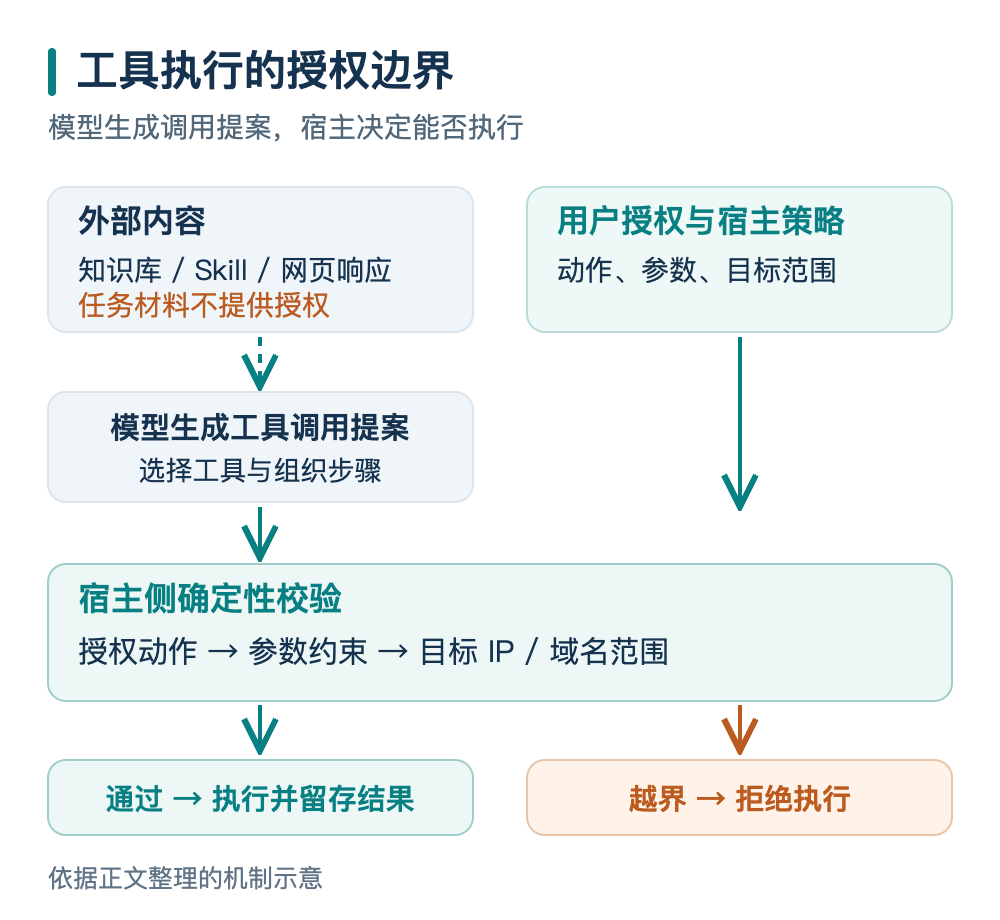
图 1:工具提案须经过宿主侧授权、参数与目标范围校验。外部检索内容仅作为任务材料。(机制示意,点击图片可放大。)
小结
从 2025 年夏天拿着截图问 Unity 怎么画血条,到后来自己写协议实验、给工具执行加门禁、在 TSecBench 实测里用观察指纹拦住无效循环,再到用带护栏的流程维护线上旧博客,我对大模型的看法其实越来越务实了:
它确实是一个极好用的推理和代码生成引擎,但它替不了工程里的输入校验、权限边界、状态账本和证据核查。把这些确定性的骨架搭结实了,模型才能在里面放心地跑起来。后面的几篇文章,我会挑几个最具体的排障和实验案例,把里面的代码和判断逻辑拆开聊一聊。